 知集软件
一副麻将,和一个自己练出来的对手
个人技术项目 · 不是知集软件的产品
能在浏览器里打的四川麻将(血战到底),1 人对 3 个电脑,加上一个从零训练的 AI。规则、界面、训练、评估都是陈佳绍一个人做的。
做成了什么,效果如何
AI 先模仿一个按规则写的程序,再靠自己和自己打了 897 万局,最后明显强过它的老师。下面的数字都是实测。
-
+1.38 分 / 局
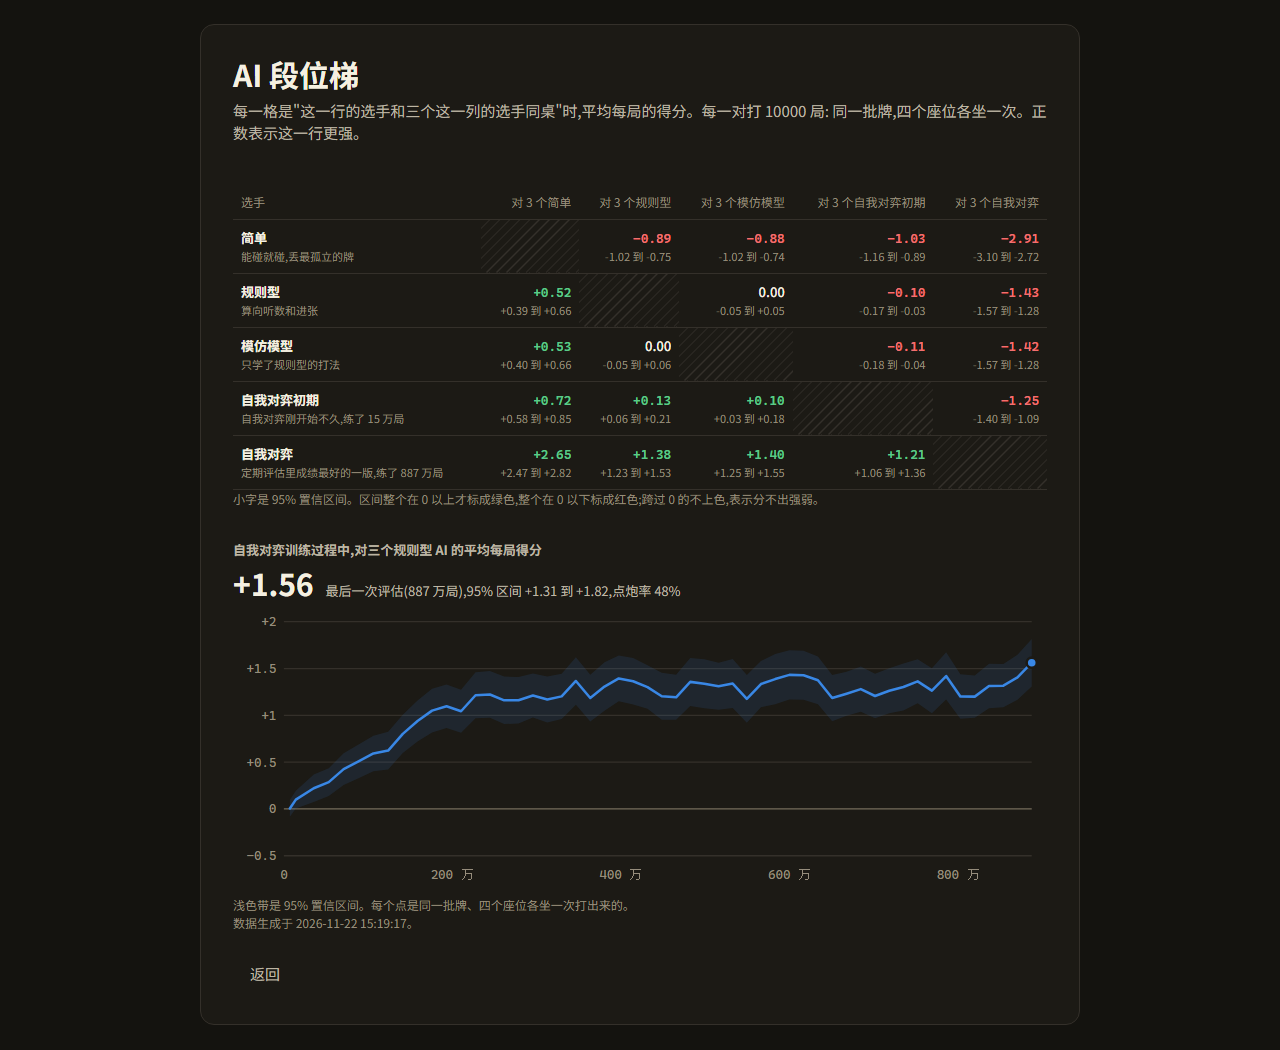
和三个规则型程序同桌打 1 万局,平均每局多赢的分数
-
897 万局
自我对弈的局数,一张 RTX 4060 Ti 上 12 小时
-
< 1 毫秒
在 CPU 上出一手牌的时间,不需要显卡
-
189 个
自动化测试,规则逐条有测试
- 能玩
- 你和三个电脑打完整的一局:换三张、定缺、碰、杠、胡、结算,连打多局,每局自动存牌谱
- AI 有多强
- 和三个规则型程序同桌打 1 万局没用过的牌,平均每局多赢 1.38 分(95% 置信区间 1.23 到 1.53)
- 练了多久
- 先模仿规则型程序,再自我对弈 12 小时、897 万局,用的是一张家用显卡(RTX 4060 Ti)
- 反应多快
- 模型导出后只有 6 MB,不用显卡,出一手牌不到 1 毫秒
- 公平
- AI 只看得到自己的牌,这一点有自动化测试证明;给你的提示也一样
在软件里能看到什么
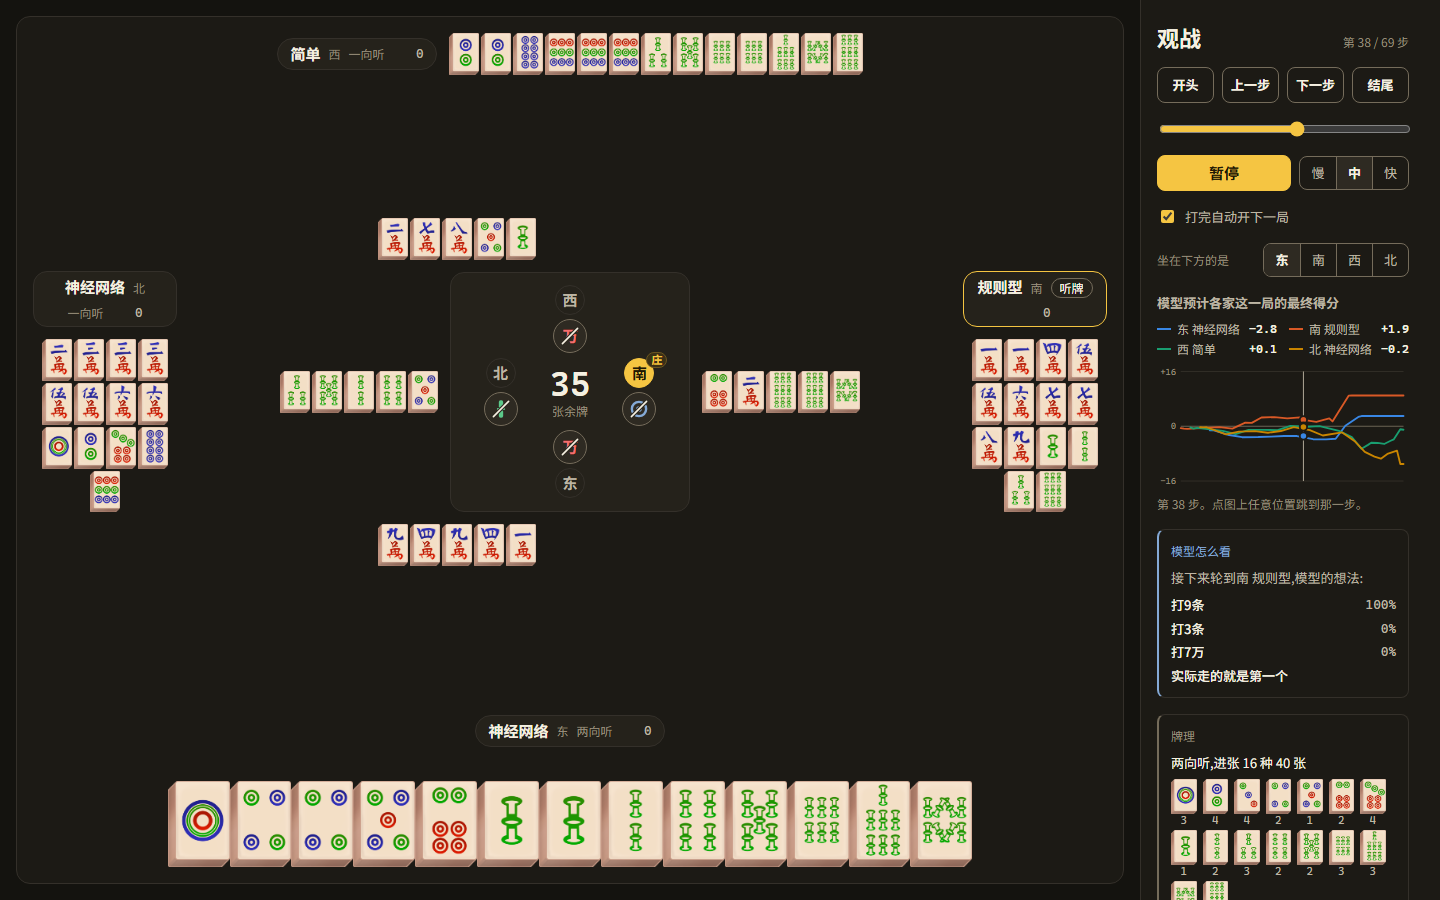
AI 不是一个黑箱:它每一步怎么想、各个版本谁强谁弱,都画在界面上。
- 概率条
- 打开提示,手牌上方的蓝条是模型打每一张牌的把握
- 估值曲线
- 模型预计四家各自这一局能得多少分,随牌局进行怎么变
- 观战
- 四个座位各放一种电脑,牌全部摊开,自动一局接一局地打,可以暂停、调速、换视角
- 段位梯
- 各个版本两两同桌对打的成绩表,加上训练过程的成绩曲线
- 听牌提示和进张
- 现在几向听、进哪些牌、各剩几张;听牌时列出能胡的牌和番数。这部分是规则算的,不靠模型
- 报牌
- 四个座位各有一个音色,打出什么牌就报什么
还做不到的
和这个网站上的产品一样,短板照实写。
- 不会防守
- 它的分数全靠进攻。别人听牌时它照样打危险牌,点炮率有 50%。
- 只有一种玩法
- 四川麻将的血战到底,其他玩法和地方规则没有做。
- 单机
- 一个人对三个电脑,没有联机。
- 没有在线试玩
- 只能把仓库克隆下来,在自己的电脑上运行。
- 性质
- 陈佳绍的个人技术项目,不是知集软件的产品
- 玩法
- 四川麻将,血战到底
- 形式
- 单机,1 人对 3 个电脑
- 试玩
- 没有在线试玩,克隆仓库后在本地运行
技术细节:怎么做出来的
下面这部分写给想看实现的人,按做的先后顺序排。
- 规则引擎纯 Python,没有界面,给定种子完全可复现。换三张、定缺、十几种番型、查花猪、查大叫、退税都有,逐条有测试。
- 规则型程序算向听数和进张,作为第一个像样的对手,也是后面的老师和标尺。
- 训练环境把一个座位看到的局面编码成 71 × 27 的数组;12 个进程并行对局,每秒五万多个决定。
- 模仿学习让一个 178 万参数的残差网络学规则型程序的选择,97.9% 的局面选得一样,实力持平。
- 自我对弈用 PPO 让它和自己的历史版本对打。训练时价值网络可以看全场的牌,出牌的那一路看不到。
- 评估同一副牌打四次,待测的一方轮流坐四个座位,抵消发牌的运气;用没见过的牌确认成绩。
- 入座模型导出成 6 MB 的 ONNX 文件,对局软件用 CPU 推理,不需要装深度学习框架。
- 模型
- 残差网络,178 万参数
- 模仿
- 97.9% 的局面和规则型程序选得一样
- 强化
- 自我对弈(PPO),12 小时,897 万局
- 硬件
- 一张 RTX 4060 Ti
- 推理
- 6 MB 的 ONNX,CPU 上每手不到 1 毫秒
- 成绩
- 每局 +1.38 分,95% 置信区间 1.23 到 1.53
- 测试
- 189 个自动化测试